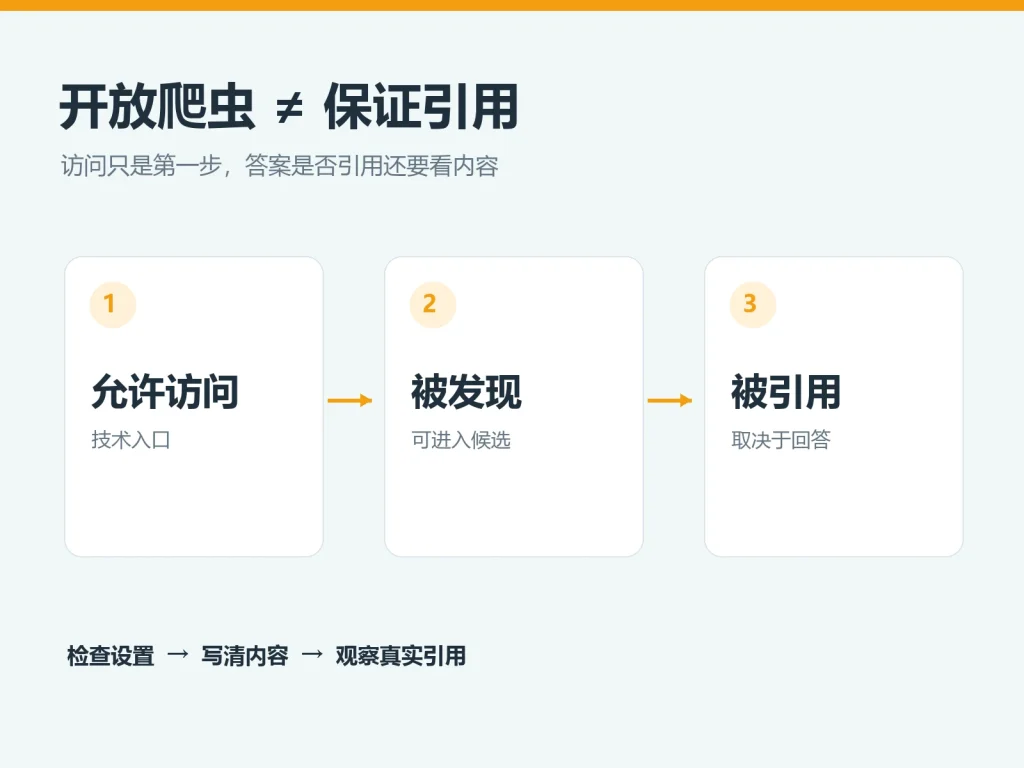
允许 AI 爬虫访问网站就能保证被引用吗?不能。放行爬虫,只是让对方有机会读取公开页面;页面能否进入搜索结果、是否与某次提问相关、回答里是否引用你的网址,还要经过后面的判断。把“允许访问”当成“保证被引用”,容易花时间改了设置,却不知道结果该去哪里看。
这篇写给管理企业官网或独立站、希望被 ChatGPT 搜索发现的小团队。先检查访问权限,再检查页面本身,最后用固定问题记录实际引用。这里讨论的是公开网页,不涉及把客户资料交给 AI。
先弄清:访问、发现、引用是三件事
“爬虫”是自动访问网页的程序。它像来店里的访客:店门开着,才可能进来;但进门并不代表它一定看完每件商品,更不代表以后向别人推荐你的店。网站管理员常用 robots.txt 告诉这类程序哪些路径可访问。
OpenAI 的官方爬虫说明把 OAI-SearchBot 用于 ChatGPT 搜索,把 GPTBot 用于可能用于模型训练的抓取。两者可以分别管理。允许搜索爬虫,不等于必须允许训练爬虫;把 GPTBot 放行,也不能替代 OAI-SearchBot 的搜索访问检查。
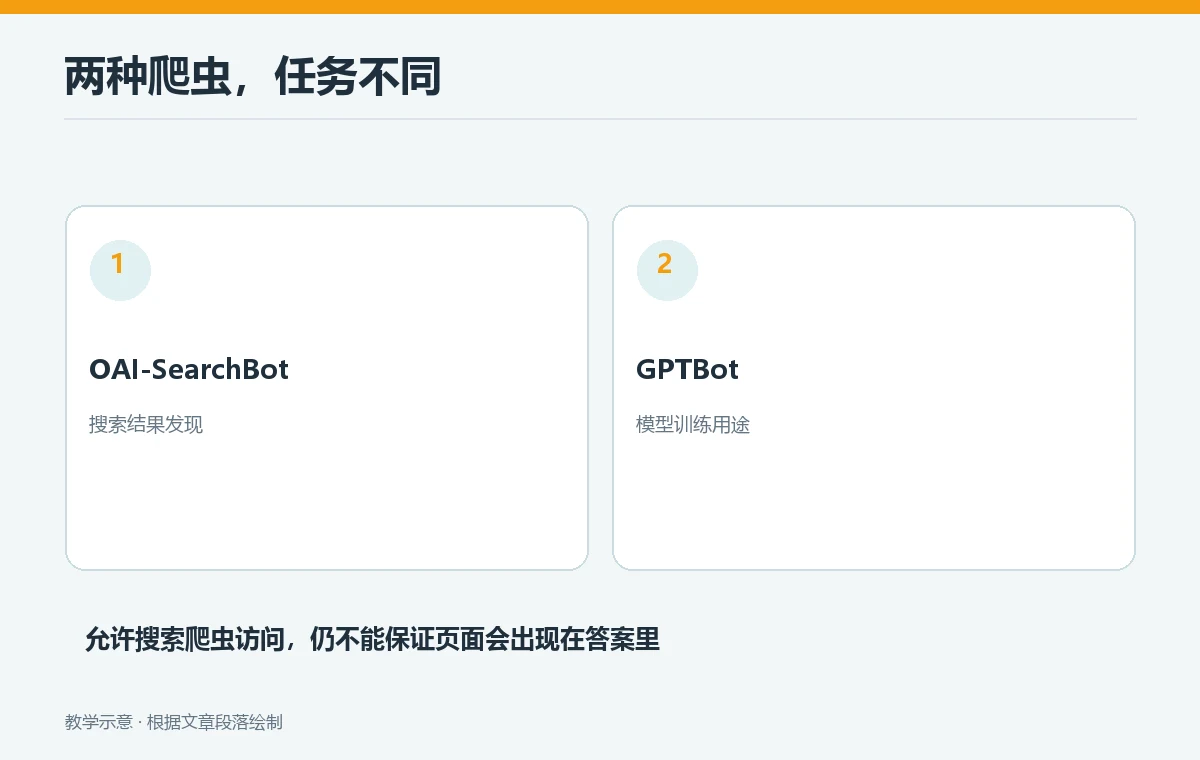
| 阶段 | 你能检查什么 | 不能据此断言什么 |
|---|---|---|
| 允许访问 | robots 规则、服务器是否正常返回页面 | 一定已被抓取 |
| 被发现或展示 | 搜索结果是否出现网址或标题 | 每个问题都能出现 |
| 被引用 | 实际回答是否有指向该页的来源链接 | 以后一直会引用 |
OpenAI 的ChatGPT 搜索说明明确说,搜索结果使用多种因素,出现位置没有保证。Google 对普通网页也说得类似:满足基本技术要求,只代表有资格被收录,并不保证收录。两者机制不同,但都不能把“技术上可访问”写成“平台承诺展示”。
第一步:查看 robots.txt,不要只看插件开关
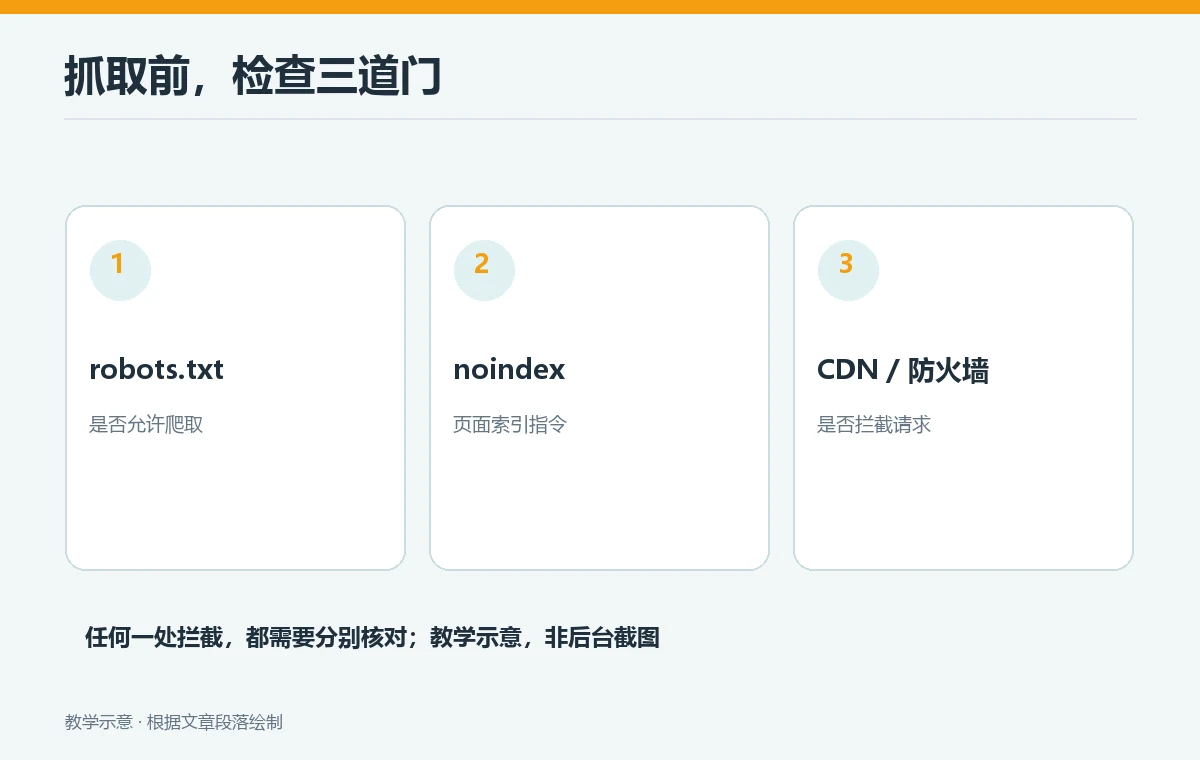
在浏览器输入自己域名后加 /robots.txt。例如 https://example.com/robots.txt。请网站管理员确认是否有专门针对 OAI-SearchBot 的禁止规则,也看看通用 User-agent: * 是否挡住重要页面。规则要按实际域名和路径核对;主站放行,不代表图片子域名或旧域名也放行。
如果不熟悉语法,不要直接复制网上一整段“AI 优化代码”。最安全的做法是让负责网站的人先保存旧文件,再确认要开放的只是已经公开、可以被搜索的页面,最后测试修改后的实际响应。若客户报价、订单或测试页面不应公开,先处理权限与隐私问题。
还要区分 robots.txt 和网页的 noindex。前者主要管理爬虫是否访问某路径;后者告诉支持它的搜索服务不要索引页面。若页面被 robots 规则挡住,对方可能根本读不到页面里的 noindex。Google 的robots 指南也提醒不要把 robots 文件当作阻止网页出现在搜索结果的唯一办法。
第二步:确认页面真的能被读取
首页打开了,不等于你希望被引用的服务页也能打开。用没有登录后台的浏览器访问具体文章或服务页,检查网址是否稳定、页面是否完整、有没有要求登录,手机上是否也能读到正文。如果经过跳转,记录最终网址;如果只出现验证题、空白页面或拒绝访问,先交给网站或 CDN 管理人排查。
CDN 可以理解为站点前面的加速与防护层。它有时会把访问频繁的机器人当成异常流量拦住,所以即使 robots 文件写着允许,实际请求仍可能失败。OpenAI 的官方说明建议同时检查主机或 CDN 是否允许其公布的搜索爬虫 IP 范围。不要只凭浏览器里“我能打开”就宣布爬虫已通过。
一个小团队可以照着做的四项核对
- 选一条最重要的公开服务页,记下完整网址与页面标题。
- 在未登录的手机和电脑上分别打开,确认正文、图片及内链可见。
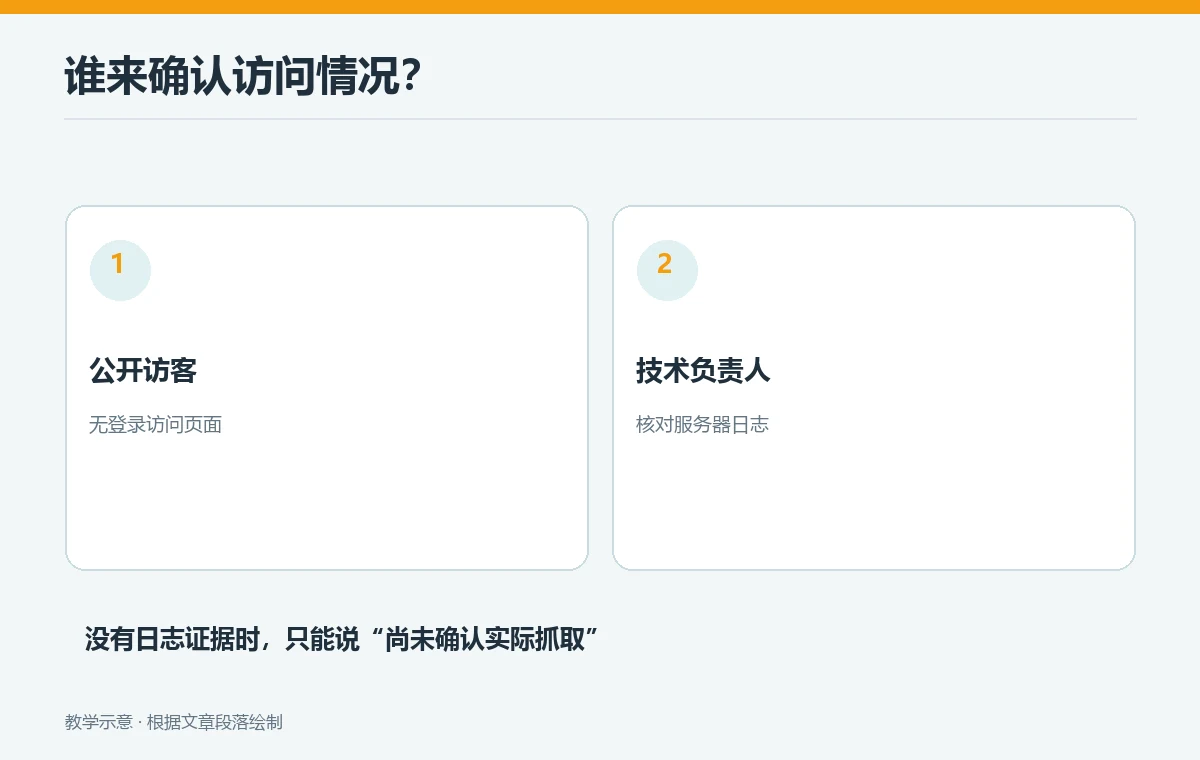
- 让技术负责人查 robots、CDN 与服务器日志;区分真实 OAI-SearchBot 请求和只是名字相似的访问。
- 修改后留下日期、改动项和页面响应,再观察是否真的出现抓取或搜索引用。
若你刚完成网站上线,先按 AIRSANG 的SEO 与内容运营责任清单指定谁管技术访问、谁管内容更新,避免出现“插件显示正常,但没人检查防火墙”的空档。
第三步:让页面回答一个明确问题
爬虫读得到,也可能不知道该在哪个问题里使用这页。比如一张只有“专业建站服务”几个字和大量装饰图的页面,读者仍看不清适用平台、交付范围或常见限制。请把服务对象、能解决的事、工作内容、证据和联系办法写清楚。案例页要说明实际做了哪些页面,不能虚构转化率或客户评价。
把一个页面当作一位愿意解释工作的同事来审读:第一次来的人能不能用一分钟回答“你们做什么、适合谁、我下一步该看什么”?缺少具体答案时,继续放开更多爬虫通常不是最先该做的事。已有文章的标题、摘要与正文也应一致,免得标题承诺了答案,打开却找不到。
相关基础工作可接着看 AIRSANG 的分类页与博客关键词分工。它讨论的是内容放在哪种页面,与本篇的爬虫访问检查是两条相接的工作:先保证页面能读,再让页面确实能回答读者的问题。
怎样验证“被引用”,而不是只凭感觉?
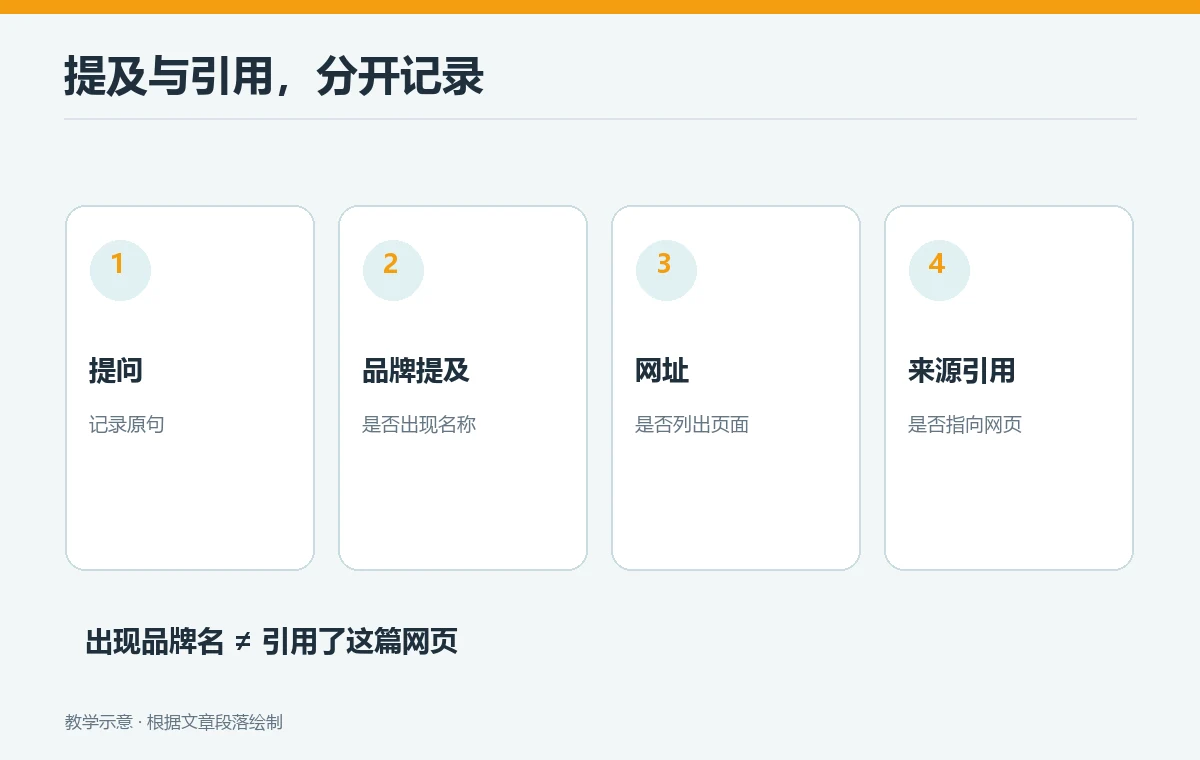
选择与你的服务页确实相关的 3 到 5 个自然问题,比如“某行业产品页面需要展示哪些资料”。固定提问语言、地区、日期和使用的平台,记录回答里是否出现你的品牌、是否有指向原网页的可点击来源链接。只提品牌但没有来源,和真正引用了某篇页面,是两种结果。
- 记录原始问题、平台、日期与回答截图或导出记录。
- 把“出现品牌”“出现网址”“被当作来源引用”分开记。
- 点开引用网址,确认不是旧页面、错误页面或其他同名品牌。
- 按相同问题周期复测,不把一次回答当作稳定排名。
AIRSANG 的AI 搜索品牌提及测试指南提供了更完整的记录方法。若本次没有被引用,先核查访问和内容,再继续观察;没有平台日志或实际回答证据,就不能说“AI 已收录但故意不引用”。
结论:先解决能否读到,再观察是否值得引用
允许 AI 爬虫访问网站就能保证被引用吗?答案是不能。放行 OAI-SearchBot、确保页面公开可读,是争取 ChatGPT 搜索展示的基础条件;引用还取决于具体问题、页面相关性及搜索系统的判断。先留好 robots 与访问响应证据,再把服务页写清楚,最后用固定问题核对实际来源链接。这条路径比购买“保证 AI 引用”的承诺更容易验收。